最近我越来越确定一件事:AI 工具会越来越多,但真正值得长期积累的,不应该是某个工具里的聊天记录,而是属于你和项目本身的记忆。
换一个模型、换一个客户端、换一个 Agent,今天已经不算难。真正麻烦的是,每换一次工具,你都要重新解释自己的偏好、项目背景、数据口径、历史决策和踩过的坑。
当团队只用一个聊天框时,这个问题还不明显;但当工作流变成“多个工具 + 多个 Agent + 多个项目”之后,记忆碎片化会迅速变成系统问题。
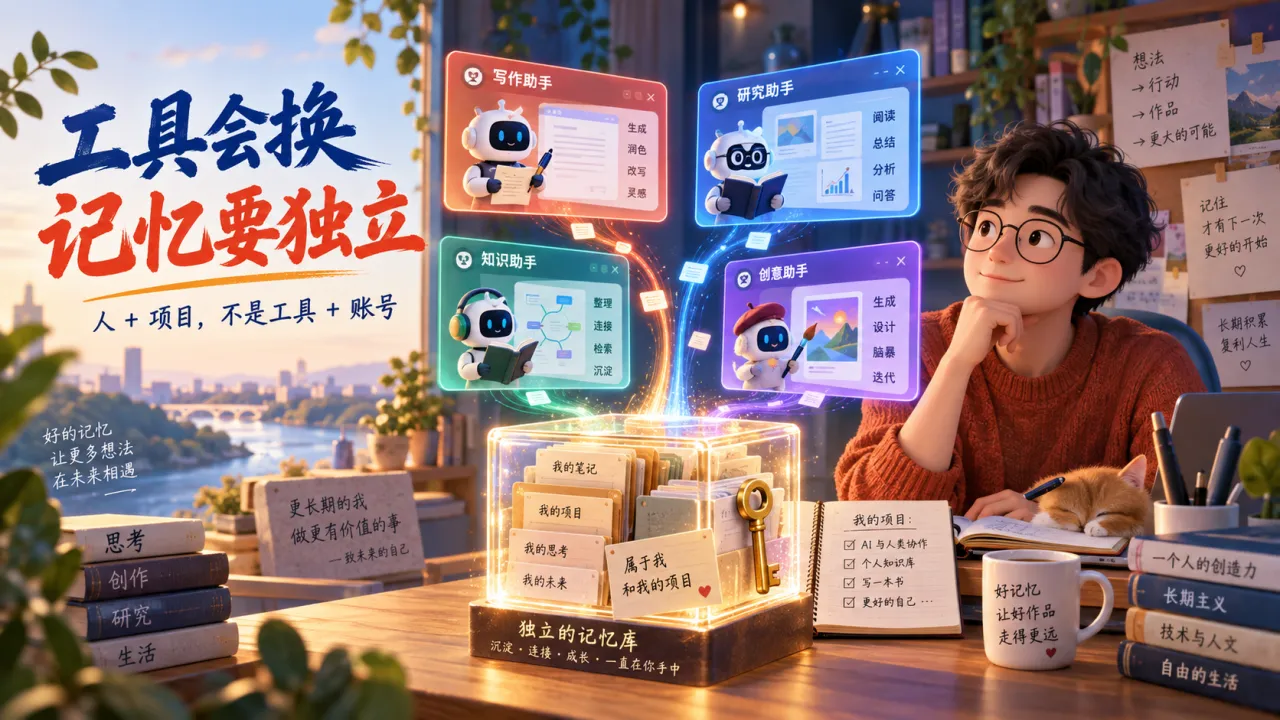
我们最近把 6 个 Agent 接到一套独立记忆层之后,得到的不是一个“更聪明的聊天机器人”,而是四个更重要的判断。
判断一:记忆应该独立于工具,而不是寄存在工具里
以前我也会把“记忆”理解成某个 AI 产品的功能:它能不能记住我、能不能延续上下文、能不能跨会话调用。
但多工具协作之后,这种理解很快就不够用了。
写作工具记得你的语气,代码工具记得仓库规则,自动化工具记得任务参数,数据 Agent 又有自己的一套上下文。每个入口都“记得一点”,最后却没有任何一个地方真正拥有完整的长期记忆。
这就像公司里每个部门都各自保存了一份客户资料,但没有统一档案。平时看不出问题,一旦换系统、换人、换项目,成本立刻暴露。
我们曾遇到过一个很典型的情况:有 2571 条记录停在本地队列里三天。进程正常、日志没有明显报错、服务也在运行,但真正的写入并没有发生。
这件事让我意识到:只要记忆仍然被看成某个插件或工具的附属能力,它就很容易被“表面正常”掩盖。
因此现在我们更倾向于用“人 + 项目”作为坐标,而不是“工具 + 账号”。工具可以更换,账号可以迁移,Agent 可以重建,但项目经验应该继续存在。
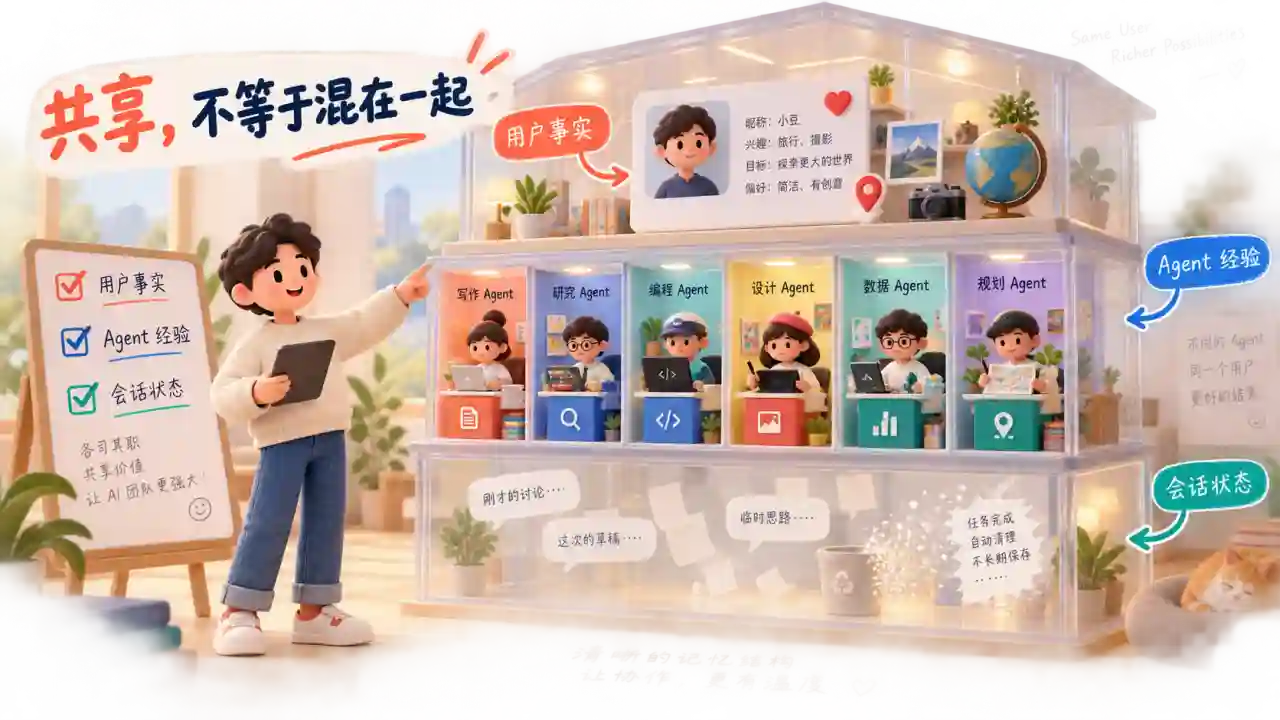
判断二:独立不等于全部共享,记忆必须分层
把记忆独立出来之后,下一个问题马上出现:是不是所有 Agent 都应该读取同一份记忆?
答案是否定的。
多 Agent 系统里,比“没有共享”更危险的是“共享过头”。一个项目的临时判断跑到另一个项目里,旧口径被当成新规则,某个 Agent 的局部经验被另一个 Agent 当成事实,都会产生很隐蔽的污染。
我们目前把记忆大致拆成三层:
- 用户事实:长期偏好、稳定习惯、身份信息等,适合跨工具共享。
- Agent / 项目经验:执行轨迹、方法论、踩坑记录、业务口径等,应该按角色和项目隔离。
- 会话状态:只服务于当前任务的临时上下文,默认可以过期,真正有价值的部分再晋升为长期记忆。
这里最容易犯的错,是“配置上分层了,就以为数据真的分层了”。我们做过一次实际审计:看上去每个 Agent 都有自己的命名空间,最终发现真正独立写入的只有一个身份,其余内容仍落在共享区域。
所以记忆隔离不能看配置文件,要看真实写入结果。身份定义、写入触发、宿主传递身份、读取权限,任何一环缺失,所谓的“分层记忆”都可能只是界面上的结构。
判断三:记忆系统最危险的不是报错,而是“静默失效”
传统系统出问题,往往会给你一个明确错误:接口超时、数据库失败、任务异常。
记忆系统最麻烦的是,它经常不会这样。
我们遇到过上下文压缩组件返回成功,但前后 token 数没有任何变化;也遇到过旧口径已经更新,却因为多个位置都保存了旧版本,导致同一天里不同 Agent 给出相互矛盾的判断。
更危险的是,这些回答通常都很“自信”。
所以现在我们的验收方式已经从“接口是否 200”变成“结果是否真的发生”。至少要验证三件事:
- 写一条,读一条:验证完整端到端链路,而不是只看服务是否启动。
- 比对前后数字:同步、压缩、清理、归档有没有生效,以数量、体积、token 变化为准。
- 故意问旧问题:用已经修改过的规则做陷阱题,测试系统是否仍然引用过期记忆。
除此之外,token 消耗、失败写入、跳过记录、磁盘占用、队列积压,都应该有独立观察口。因为记忆系统一旦不可观察,它迟早会从“长期资产”变成“长期黑盒”。
判断四:Agent 要轻,记忆要重;工作流围绕场景,而不是围绕模型
这是这次实践里我最看重的一点。
如果 Agent 本身绑定了太多长期知识、历史习惯和项目上下文,那么每次换模型、换工具、换运行环境,都意味着一次昂贵迁移。
更合理的结构应该反过来:
Agent 保持轻量,负责角色与能力;记忆层保持稳定,负责长期积累。
这样一来,研究 Agent 可以从一种模型切到另一种模型,写作 Agent 可以换客户端,开发 Agent 可以迁移到新的执行框架,但它们仍然读取同一套经过治理的项目记忆。
最终真正稳定的就不再是某个模型,而是业务场景本身。
比如“做一篇小红书爆文”“生成一套电商主图”“复盘一个项目”“分析一份经营数据”,这些才是应该长期保留的工作流。模型只是当前阶段完成任务的能力组件,不应该反过来定义整个系统。
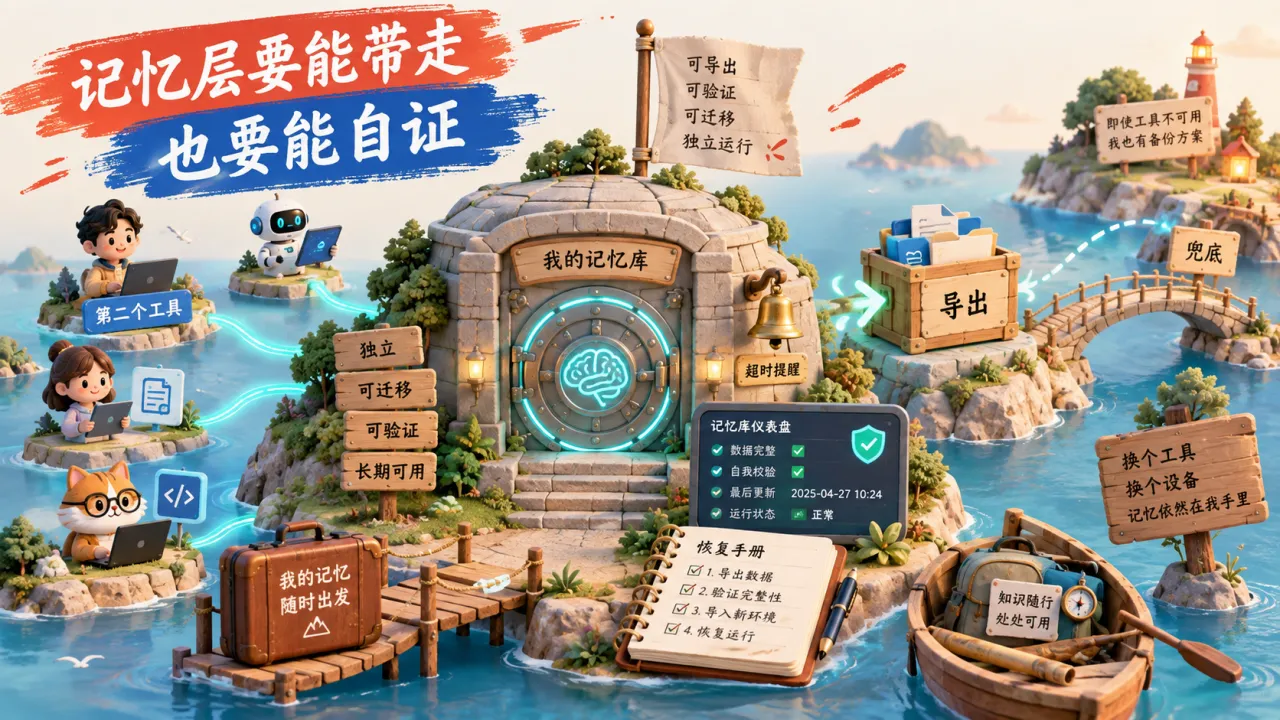
从“会记住”到“可迁移、可复核、可恢复”
所以现在我们判断一套记忆系统是否值得长期使用,不再看它有没有一个叫“Memory”的功能,而是看它是否具备下面这些能力:
- 记忆以人 + 项目为核心坐标,而不是绑定单一工具。
- 不同类型的记忆有清晰边界,能共享,也能隔离。
- 写入、读取、压缩、清理都有可观察指标。
- Agent 可以更换,而项目记忆无需重建。
- 数据可以导出、迁移,并且能做恢复演练。
- 最终验收靠实际回读,而不是“感觉它记住了”。
这并不是说工具自带的记忆没有价值。恰恰相反,它们通常最方便,也最适合处理短期上下文。
但当你的工作开始跨工具、跨账号、跨 Agent、跨团队时,真正重要的经验就不能只寄存在某个产品里。
工具越换越快,记忆反而越应该独立。
因为未来真正有价值的,不是你今天用了哪个模型,而是几年之后,你积累下来的项目判断、方法论、偏好、失败经验和决策依据,还能不能继续被下一代工具调用。
如果可以,那些记忆才真正从“聊天记录”变成了你的 AI 资产。
边界说明:本文来自我们在多 Agent、独立记忆层和实际项目工作流中的运行记录与复盘。文中数字与案例仅对应当时环境,用于说明问题,不代表任何厂商或产品的通用表现。