9 月 11 日,我把自己一直在跑的小红书内容生产流程,打包成了 xiaohongshu-viral v1.0.0,并写了那篇《0 推流跑出 703 万曝光后,我把方法做成了 Skill》。
那篇讲的是「为什么值得把流程做成 Skill」。这篇讲另一件事:1.0 只覆盖了「从 0 写一篇」,而真实工作里,还有一大块它管不到。管不到的地方很具体:
- 标题写完,不知道该不该发,只能凭感觉挑一条
- 老笔记数据差,本能反应是删稿重写,但其实问题可能只在封面
- 封面全靠感觉,没有稳定的取数和解构方法
- 想复盘,但环境里没有数据源,就不知道该怎么人工做
这四件事都不是「写稿」,但每一件都直接决定内容能不能跑量。所以从 v1.1 到 v1.2,我一直在补这一块。
现在 v1.2.0 出来了。包体从 v1.0.0 的 18 个文件,扩到 23 个。
一、标题六维评分卡:写完先打分,再决定发不发
这是这次最实用的一个新增能力。
以前的流程里,标题是「先写 5 个,再挑一个」。问题是:挑的时候还是靠感觉。到底这版能不能打,没有稳定的判断标准。
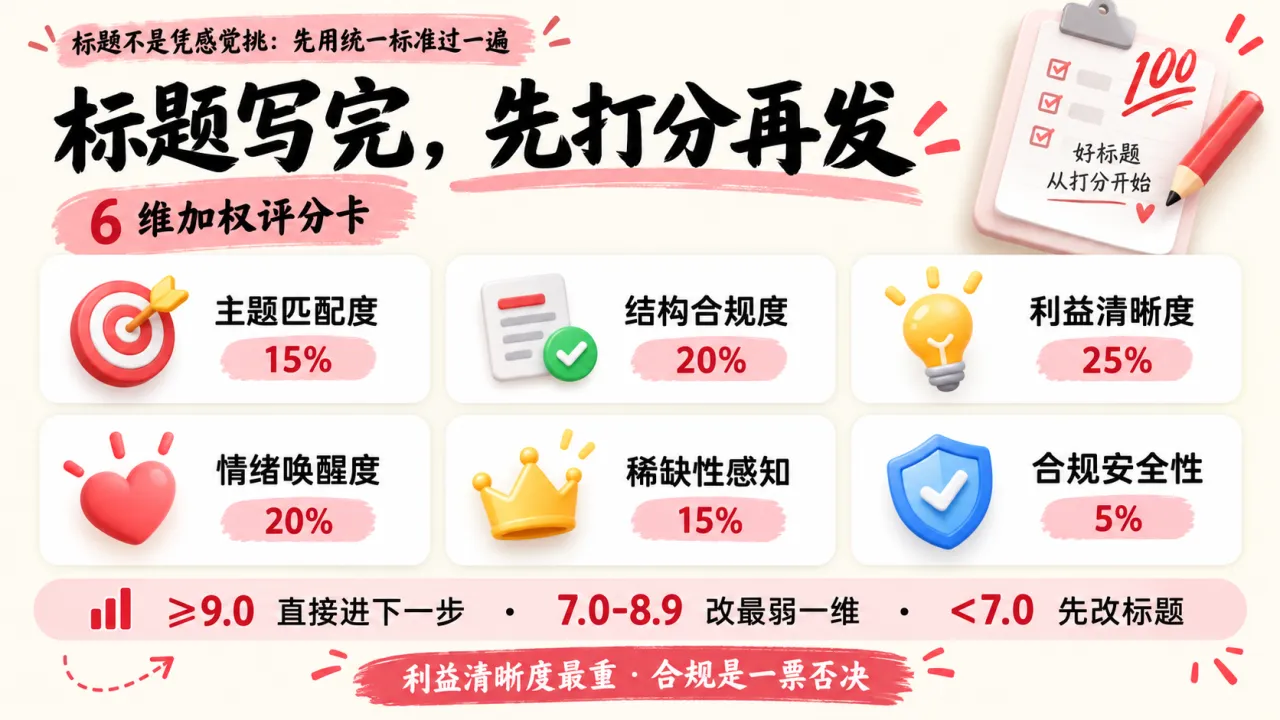
现在多了一步——先把标题过一遍六维加权评分,再决定要不要继续。
六个维度:
- 主题匹配度(15%):有没有踩中同赛道当下热点词
- 结构合规度(20%):有没有钩子 + 有没有利益
- 利益清晰度(25%):能不能一眼看懂「我能得到什么」
- 情绪唤醒度(20%):有没有好奇 / 焦虑 / 爽点 / 惊喜
- 稀缺性感知(15%):有没有差异化、不可替代的表述
- 合规安全性(5%):有没有限流词、功效承诺
权重是有讲究的:利益清晰度最重(25%),情绪次之(20%)。先让人看懂「我能得到什么」,再让人心动。合规只占 5%,不是不重要,而是它属于一票否决——一旦踩线,整条标题直接判 C,不参与优化讨论。
打完分出来是 S / A / B / C 四个等级:
- S(≥9.0):流量潜力顶部区间,爆款要素齐备
- A(7.0-8.9):达标,可以直接进下一步
- B(5.0-6.9):有缺陷,要针对性优化
- C(<5.0):建议重写
这张标题评分卡还和原来的 /50 整篇评分做了分工衔接:标题分 ≥9.0 且整篇 ≥45,可以直接发;7.0-8.9 就挑最弱的一维改一版再评;低于 7.0,先改标题,别带着 B 级标题去凑整篇的分。
顺带一个细节:如果标题和同赛道已验证的爆款完全一致(或只差标点空格),直接记 S 级,标注「与已验证爆款重合」,不再走常规打分——它已经被市场验证过一次了。
二、旧笔记诊断:点击率低,先怀疑封面,不是标题
第二个新增能力,解决的是「老笔记没流量,该改哪」这个问题。
以前遇到这种情况,最常见的反应是删了重写。但重写成本高,而且很可能改错了地方——你以为是文案不行,其实问题在封面。
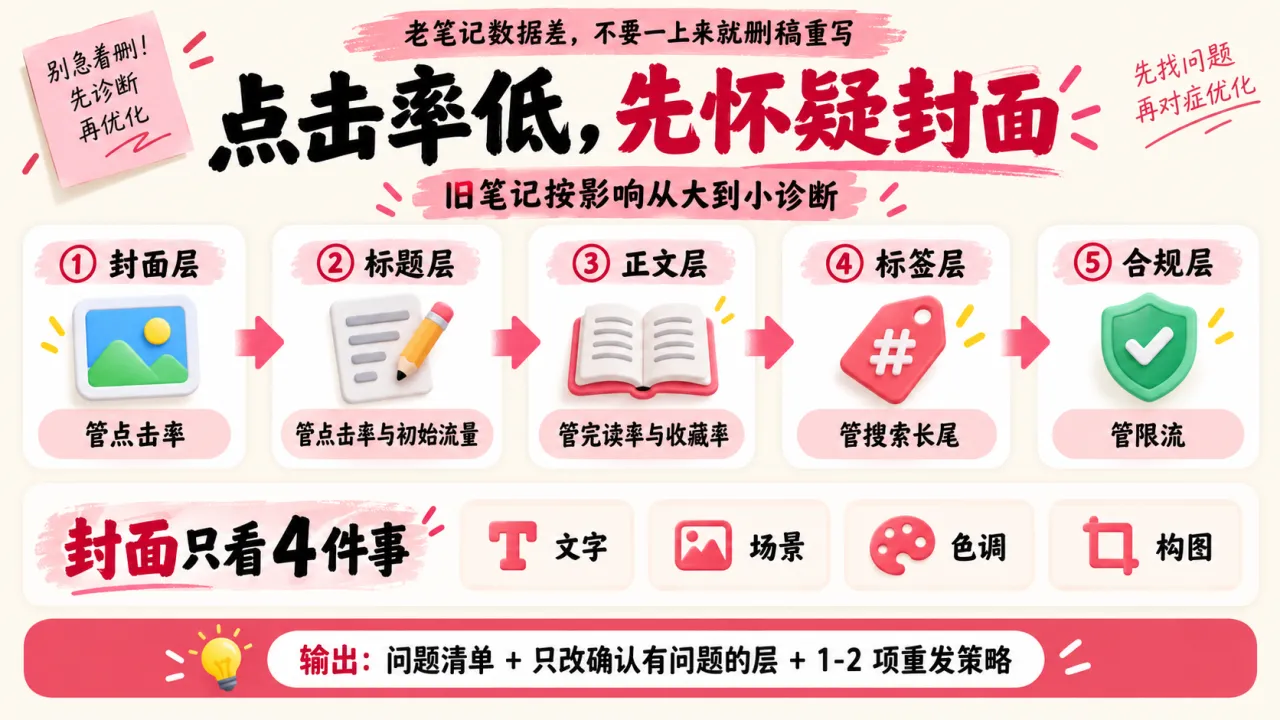
所以这次把旧笔记诊断的顺序固定下来了,按对结果的影响,从大到小排五层:
- 封面层:管点击率
- 标题层:管点击率与初始流量
- 正文层:管完读率与收藏率
- 标签层:管搜索长尾
- 合规层:管限流
关键判断落在最前面那层:点击率低,先怀疑封面,不是标题。
诊断封面的时候对照同赛道爆款看四件事:文字、场景、色调、构图。最后结论只会落在两个之一——「信息看不清」还是「调性不匹配」。这两个的改法完全不同,混在一起改就是浪费功夫。
输出也做了约束:
- 问题清单:按影响排序,每条带证据(真实数据,或可查的同赛道对照)
- 改写版本:只改确认有问题的那几层,不整篇重写
- 重发策略:换封面 / 改标题 / 拆选题 / 改发布时段,选 1-2 项执行,不要全上
- 复查指标:改完先盯哪个数(通常点击率先动)
红线也写死了:结论必须基于真实数据或可查的同赛道参考。数据缺失就说「这是假设」并给出验证方法。不编数据、不编互动量、不编参考笔记。
三、封面设计方法:从「凭感觉」到「有取数线」
封面是流量池晋级的头道闸。但以前它是最靠感觉的一环。
这次补进去的是一套固定的封面设计操作方法。
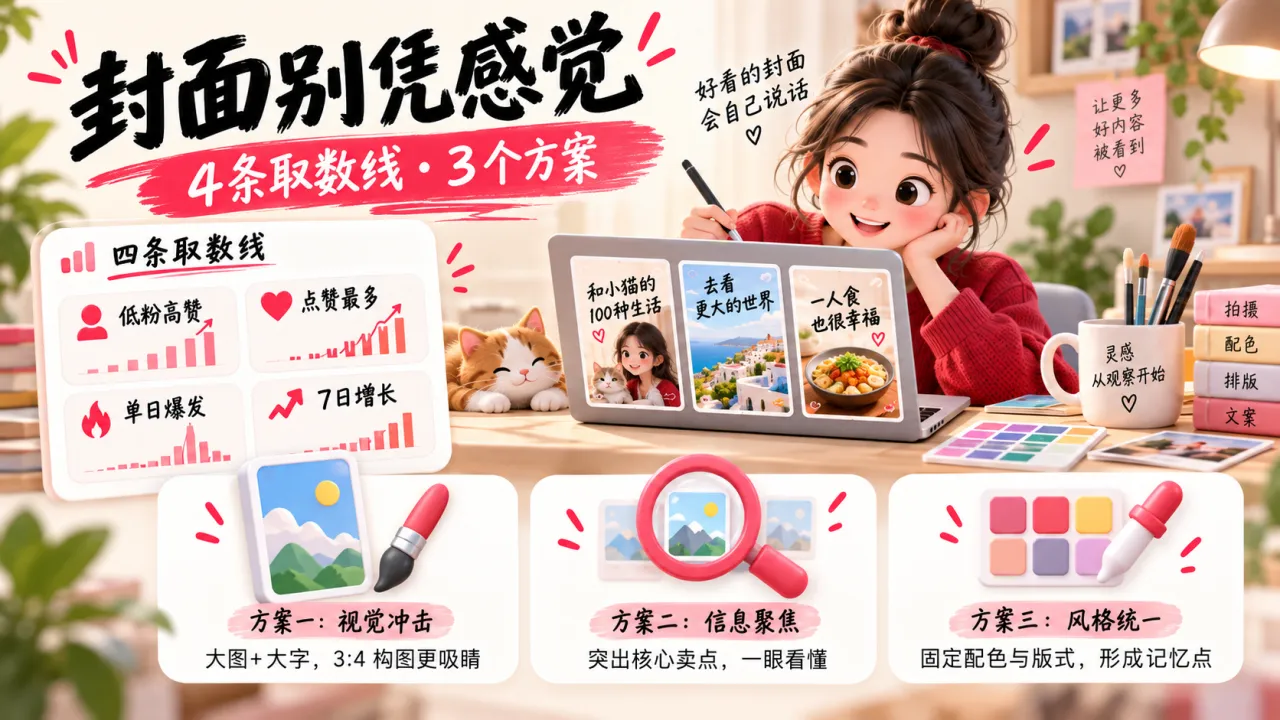
硬规格先定死:3:4 竖版,导出 1080×1440,按手机端信息流来设计——文字要一眼看清。
找参考按四条取数线:
- 低粉高赞:粉丝少但互动高,说明内容本身能打
- 点赞最多:热度上限在哪
- 单日互动爆发:突然起量,踩中了当下节奏
- 7 日持续增长:长尾能力
拆视觉规律的时候逐张拆、再归类,每张记四条:文字(主副文案、字数、字号占比、位置)、场景、色调、构图。拆完归类数频次——写「X/N」,必须带分母。
最后出 3 个差异化方案,每个都要有:风格名 + 核心视觉一句话 + 关键特征 + 主文案(≤10 字)+ 副文案(≤15 字)+ 生图提示词(必须写明 3:4 竖版)。
三个封面方案要在视觉策略上真的不同(比如信息流 / 情绪流 / 对比流),不是同一张图换个颜色。
四、数据复盘:没有数据源,也要能人工做
第四个新增能力,是给「复盘」补一条不依赖外部接口的路径。
这个 Skill 到现在依然不绑定任何外部数据接口。环境里有数据源就用,没有就按固定方法人工复盘。
里面有几条我踩坑之后写进去的规则。
关键词先分型:细分词(职场穿搭、减脂餐)直接查;具体产品词直接查、不扩展到相邻形态;泛化词(美妆、穿搭、美食)先给 10 个细分方向,等对方选。
产品形态边界是最容易查错的地方——用户给什么形态就只查什么形态:
- 霜 ≠ 喷雾 ≠ 衣 ≠ 帽 ≠ 伞:「防晒霜」只查膏体/乳液状,不含防晒喷雾、防晒衣、防晒帽
- 膏 ≠ 液 ≠ 粉 ≠ 笔:「睫毛膏」不含假睫毛、睫毛增长液
- 液 ≠ 霜 ≠ 膏 ≠ 气垫:「粉底液」不含气垫、BB 霜、粉底膏
- 跑鞋 ≠ 运动鞋 ≠ 休闲鞋
时间窗口:第三方数据普遍有入库延迟,通常只覆盖昨天到 30 天前,互动数截止入库时间,不是实时。样本不足的时候,先扩时间,不换词:近 1 天 → 3 天 → 7 天 → 30 天,每扩一次都要告知需求方。
规律提炼的硬要求:占比必须带分母——写「防晒(8/10)」,不写「防晒占 80%」。样本少于 5 条要标注「样本较少,仅供参考」。样本为 0 就直接说「无相关数据,无法提炼规律」,不许编。
顺手修掉的几个问题
除了四个新能力,这几轮还清了一批旧账。
机检误报。这是最影响信任度的。检查脚本 xhs_check.py 会在英文单词内部做子串匹配,导致像 Glasswing 这种词里的 ass 被误判成风险项。这次加了英文单词边界过滤,同时改成识别问号结尾的互动引导句——反向测试也过了:真的没写互动引导,依然会报警。
违禁词库扩容。从 v1.0.0 的 11 组扩到 16 组 / 89 条规则,分 high / medium / low 三级。
修掉 v1.0.0 的机检缺陷:H1 与数字型标题识别、退出码语义、8 处漏检词、结构告警被 ✅ 掩盖、合规声明误报。
加了防分叉的校验脚本。这类 Skill 最怕的就是「文档改了、数据没改」——check_word_coverage.py 专门校验文档与 JSON 数据是否一致。因为脚本读的是 scripts/data/*.json,光改 .md 是不生效的。
统一了几个口径:标签数量统一为 5-8 个;术语统一说「爆款封面」「热门笔记」,不用「抓取」「爬取」这类表述。
新增「看起来合规其实会被打回」清单:语义级功效暗示、组合触发、弱写法、账号级风险——明明没有违禁词,还是被打回,基本都栽在这里。
没变的东西
有几条硬规则,从 1.0 到 1.2 一直没动。
硬闸门。检查脚本退出码 0 通过 / 1 有 high 风险(必须改完重跑)/ 2 有 medium 风险(建议改)/ 3 是输入或环境错误——不是内容风险,别当违规处理。出现 high 风险不准带病交付。
品类先于公式。骨架可以复用,但句式、话术、违禁词清单不能跨品类借用。换品类要先过品类适配指南。
零外部依赖。脚本只依赖 Python 3 标准库,不需要装任何东西。这次升级也没有引入任何外部接口或第三方内容。
不编。不编数据、不编案例、不编参考爆款。产品事实(成分、使用方法、适用人群禁忌、价格)不确定就必须问。
怎么拿
这次发的是 xiaohongshu-viral v1.2.0 压缩包,不是安装地址。需要领取的朋友,可微信联系获取压缩包。
补充一句:如果你的环境和 1.0 时代不同了(换了 agent 框架、换了平台),可以顺手告诉我,我把安装路径和 frontmatter 对应的那部分单独说一下——这部分三个平台的口径不一样。
说明:文中的方法来自实际项目沉淀,案例与数据已脱敏。方法可复用,结果会受账号基础、品类、内容质量和平台环境影响。