以前我使用 AI,最累的事情之一,是反复介绍自己的工作。
一个对话聊了很久,AI 终于理解了项目背景、我的要求和前面做过的选择。换一个对话,很多事情又要重新讲。
于是我养成了一种习惯:聊完一个阶段,让 AI 总结;再把这份总结复制到下一个会话里。换一个工具,再搬一次。
那时候,我其实在亲自做一件事:给不同的 AI 传递工作记忆。
今天想分享的,就是我怎样从这一步,走到搭建一套可以让多个 AI 共同使用的记忆系统。
1. 只有网页聊天时,我是 AI 之间的“交接人”
最早主要使用 DeepSeek 网页版的时候,我还没有现在这样的智能体工作台。
任务在对话里推进,背景也留在对话里。我得记住哪段讨论放在哪里,再决定给下一个 AI 带过去什么。
聊天记录可能还在,但新会话并不会天然继承我希望它掌握的全部背景。对我来说,关闭一个窗口,就很容易失去工作的连续性。
比如,一个项目已经确定了目标客户、表达风格和不该再重复的错误。换一个会话后,如果只说“继续帮我做”,它可能根本不知道要接着哪一步做。
我逐渐发现,使用 AI 的成本里,有相当一部分是交接成本:重新找资料、重新讲背景、重新确认边界。
我希望积累下来的工作,能让下一次协作更容易开始。
2. 深入研究 OpenClaw 后,我开始理解智能体怎样工作
今年年初,OpenClaw 受到关注的时候,我在家花了七天深度研究。
那段时间最大的收获,是开始理解:一个能持续做事的 AI,除了大模型,还需要工作环境、工具、规则、状态和记忆。
可以把工作过程理解成:接到任务,读取必要背景,制定步骤,调用工具,观察结果,再决定下一步。
模型负责推理与表达;运行框架负责把工具调用真正执行出来;文件、会话记录和外部存储负责留下可再次读取的信息。
我当时觉得很有意思的“三省六部”
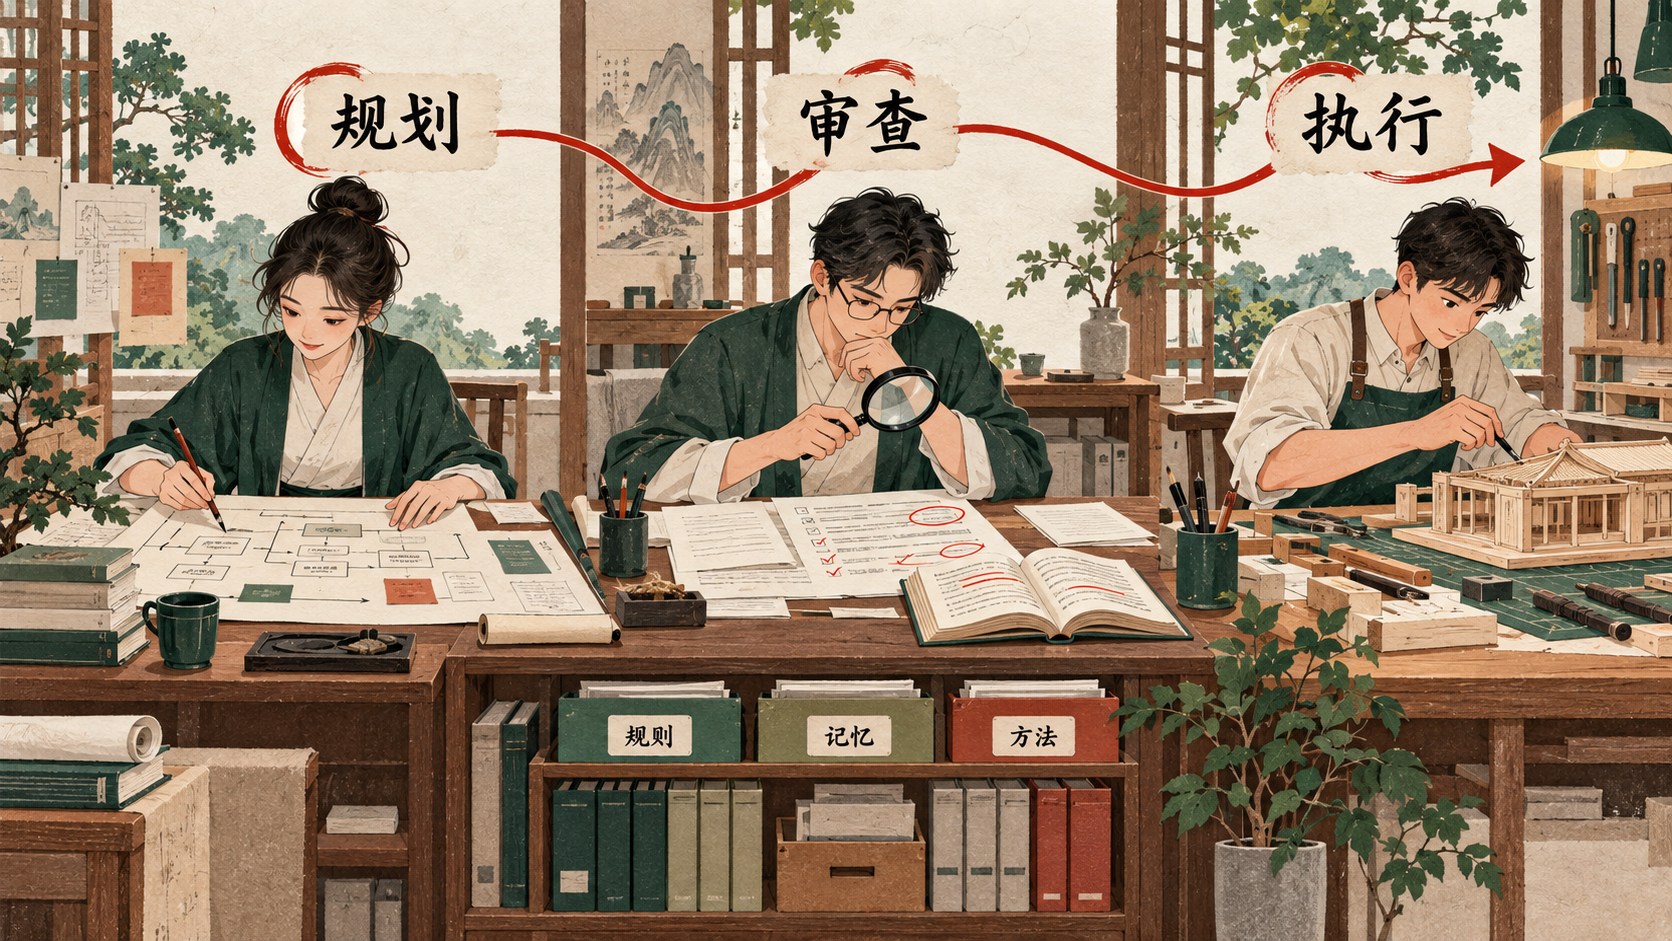
社区里有人借用“三省六部”来组织多个智能体。以 Edict 这样的社区项目为例,可以把它理解成三个主要环节:中书省拟方案,门下省审方案,尚书省协调执行,再交给不同专业角色完成工作。项目说明
如果用来做一次活动策划,就是有人负责拆需求,有人检查预算和风险,再有人分别做内容、数据和执行。
这里有启发的部分,是把规划、审查、执行分开,让意见能够被检查、任务能够被交接。它是社区的组织设计,不是 OpenClaw 必须采用的官方工作方式。
现在我的看法也更务实:简单任务直接做,复杂任务再分工。角色数量本身不代表工作质量,每多一次交接,都要承担信息损失和沟通成本。
那些配置文件,到底在告诉 AI 什么
当时看各种教程,常常会遇到一堆 Markdown 文件。把它们放回工作场景,就容易理解了:
| 文件或位置 | 可以怎样理解 |
|---|---|
AGENTS.md |
工作说明:遵守什么规则,怎样开展任务 |
SOUL.md |
表达风格、行为原则和边界 |
USER.md |
关于用户的稳定偏好、背景与工作要求 |
IDENTITY.md |
智能体的名字和身份设定 |
memory/YYYY-MM-DD.md |
当天发生了什么、做过什么决定 |
MEMORY.md |
从记录中整理出的长期事实和重要决定 |
skills/、SKILL.md |
一类任务应该怎样完成,以及所需的辅助材料 |
旧教程还常见 TOOLS.md、HEARTBEAT.md。截至本稿核验,OpenClaw 当前文档已把它们列为退休文件;本地工具约定转到 AGENTS.md 的 Tools 部分等现行入口。具体配置要跟实际版本走。尤其要记住:写下一句“可以使用某工具”,并不会自动安装工具或授予权限。工作区说明
我怎样理解“三层记忆”
为了讲清楚,我会把智能体记忆分成三层。这是工作上的讲解模型,并非统一的官方分层:
- 眼前的工作记忆:这次任务做到哪一步,还在等什么。
- 长期事实与知识:用户偏好、项目背景、资料和已经确认的决定。
- 做事的方法与经验:什么做法有效、什么条件下会失败,以及可复用的 Skill。
配置记忆时,重要的是约定清楚:哪些信息值得留下,存在哪里,什么时候检索,发现旧信息错误时怎样修正。只把所有聊天堆进一个文件,仍然会遇到难找、过期和相互冲突的问题。
落到 OpenClaw 的配置,我会按四步做:先确认当前 Agent 实际使用的工作区;把记忆读写规则放进 AGENTS.md,把稳定信息与逐日记录分别整理;需要语义检索时,再配置受支持的 Embedding 服务或本地模型;最后在旧会话留下已确认的信息,换新会话换一种问法检索,检查能否找对并读回原文。写了记忆文件、索引完成、召回准确,是三个要分别验证的状态。官方记忆说明
3. 从向量检索,到《智能简史》给我的启发
通过 OpenClaw,我开始接触向量检索。
它可以把文字映射成一组数字,让系统根据语义接近程度寻找内容。
比如,我以前记录的是“别把透明底商品图生成白色背景”,后来问“这个素材的底图要求是什么”,即使说法不同,也有机会找到那段记录。实际系统通常还要结合关键词、项目范围和相关性检查。
这里有一个我踩过的坑:主题接近,并不代表能回答问题。
问“个人技能存在哪里”,系统找回一段“服务器怎样恢复”的经验,两段都提到同一个产品,答案依然可能不对。向量检索负责帮我们找到候选内容,最终还要检查候选内容有没有支持答案的证据。
后来读麦克斯·班尼特的《智能简史:进化、AI与人脑的突破》,我开始从另一个角度看这件事。书中以几次重要的进化突破,串起智能能力的发展,并讨论这些发展对 AI 的启发。出版社介绍
它让我更关注:智能需要怎样利用过去的经验,才能做出更好的下一步选择。
不过,不能因此说“现在的 AI 已经在完整复刻人脑”。人工神经网络借鉴了生物神经系统的一些思想,却是高度抽象的计算模型;人的神经元、身体、感知与学习过程远比这个类比复杂。诺贝尔奖科普说明
时间尺度也要讲准确:智人大约出现于三十万年前,人类大脑的发展还有更久远的演化背景;人工智能作为研究领域通常追溯到 1956 年,至今约七十年,不能笼统说只有十几年。史密森尼人类起源资料;达特茅斯 AI 历史
对我最有用的启发是:想让 AI 长期参与工作,就要认真设计它怎样记录、检索、纠错和复用经验。
我们给 AI 接一个外部记忆库,通常也没有修改模型本身的参数,而是在下一次工作时,把相关资料重新提供给它。
4. 让多个AI共用一套记忆
我后来尝试用飞书知识库管理资料和 AI 工作记录,也用过 Obsidian。
飞书适合在线协作;Obsidian 把笔记存为本地 Markdown 文件,也支持同步和扩展。它们都有自己的长处。Obsidian 存储说明
随着使用加深,我的需求也变了:除了方便自己整理,还希望不同 AI 工具能够读取同一份知识,留下工作记录,并在下一次任务里找回相关内容。
这涉及资料接入、身份权限、检索、回写和维护。我当时想找的,是能把这些环节组织起来的基础设施。
后来,我找到了 OpenViking。
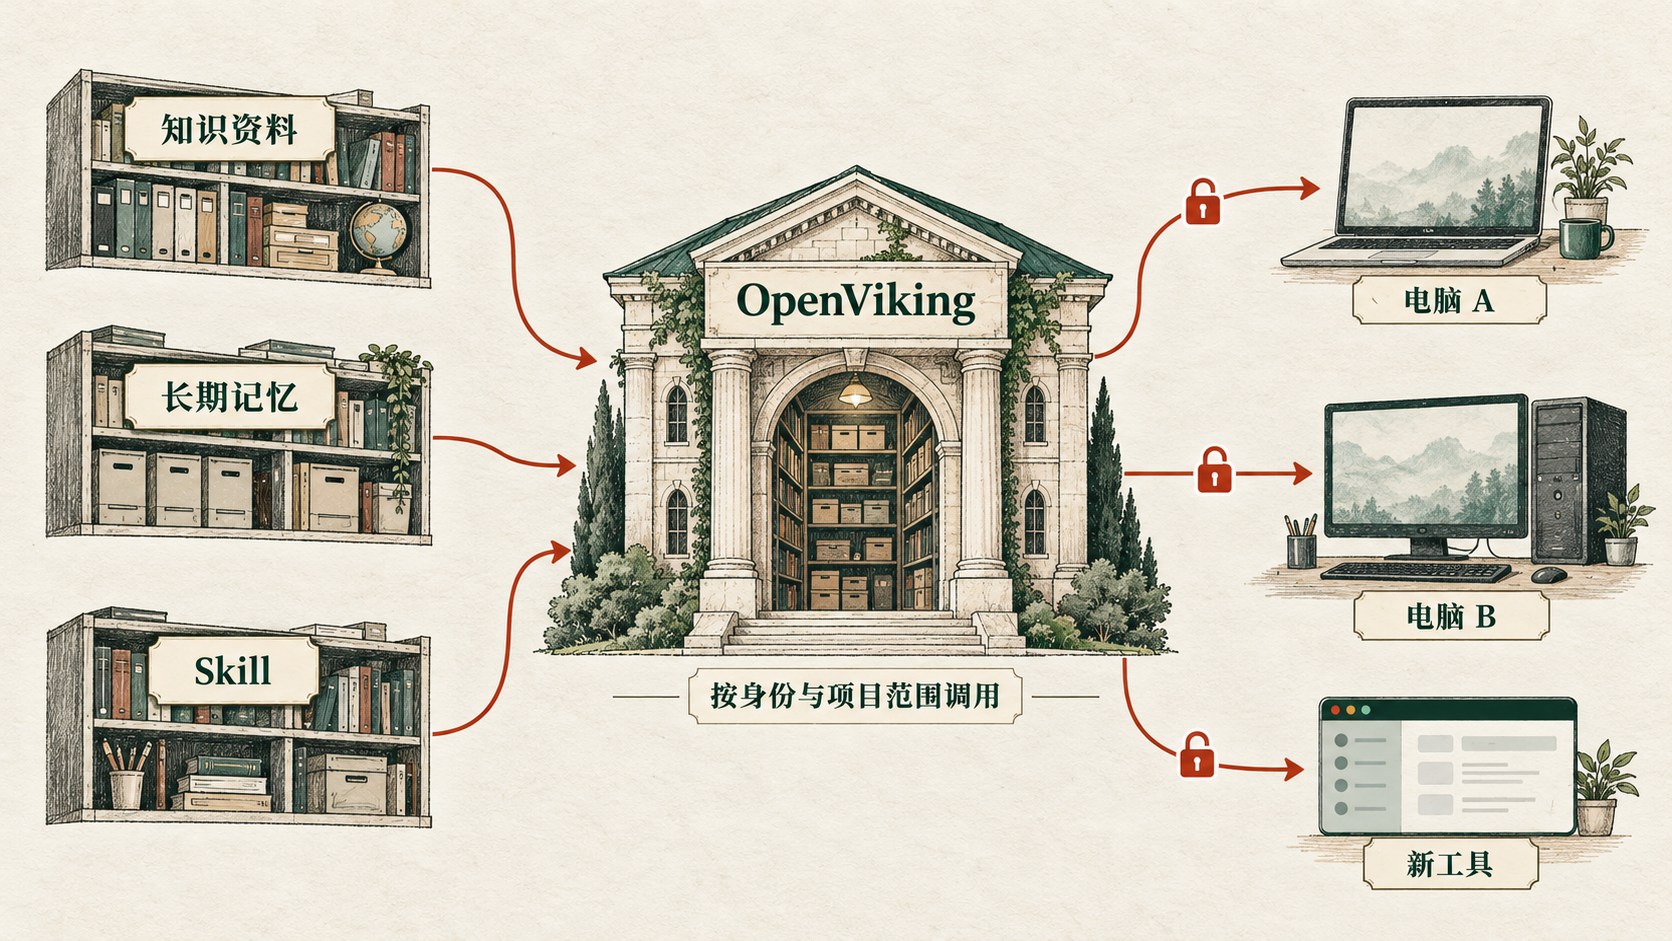
它是火山引擎团队开源的、面向 AI 智能体的上下文数据库,把资料、记忆和技能组织进统一的虚拟文件系统,通过 viking:// 这样的地址访问。项目主页
我会用下面这张示意图讲解它的能力:
(能力关系见本章配图;这是讲解示意,不是内部系统拓扑。)
其中有三个概念很重要:知识库保存参考材料,记忆库保存与工作有关的事实和经验,Skill 保存可重复使用的做事方法。三者能配合,但不必混成一份超长提示词。官方介绍
OpenViking 还有 L0、L1、L2 的分层读取:先看简短摘要,再看概览,需要时才读正文。像查一本书时先看目录和简介,再翻到相关章节。这里的摘要、概览主要是目录级材料,并不保证每个文件都有固定的三份副本。分层说明
这套 L0/L1/L2,与前面为讲解划分的“三层记忆”是两件事,不能混用。
换工具、换模型、换电脑,工作能不能接着做
这是我特别看重的地方。
我希望,上午在一台电脑上和一个 AI 确认了项目要求,下午换电脑、换模型或换工作台时,新的 AI 能找到这些要求,不用再从头交代。
实现的关键,是让获得授权的工具连接同一个记忆服务,并使用正确的用户身份和项目范围。
OpenViking 为 Codex、OpenClaw、DeepSeek Harness 等提供不同集成,也有 MCP 接口;不同接入方式的自动召回、捕获和提交能力并不完全一样。官方集成说明
所以,“安装 MCP 后就自动继承全部能力”需要拆开看:
- 连接成功:新工具能够访问这个服务。
- 找到记忆:能够搜索并读回需要的历史内容。
- 自动参与工作:在合适时机召回背景,并按策略记录新过程。
- 执行 Skill:除了读到方法,还要有对应工具、运行环境和权限。
举个例子,新的 AI 读到了“如何发布文章”的 Skill,并不意味着它立刻拥有公众号发布权限。资料和方法可以共享,执行条件还要逐项满足。Skill 执行边界
同样,跨网络也有前提:网络可达、身份有效、服务正常。跨项目共享更要有范围,个人偏好可以复用,某个客户的私有资料就不能随意带到另一个项目里。
我期待的使用体验,是更换工具时能较快接上工作;真正要验收的,是同一份已确认信息,能否在另一个会话里被准确找到和正确使用。
5. 让笔记和Skill进入下一次工作
以前我也用过印象笔记、语雀这样的工具。
我的实际感受是:整理笔记时很认真,真正做事时却未必记得回去翻。资料保存了很多,使用时还是凭印象重找一遍。
这并不是对所有人的判断,但它确实是我想解决的问题。
语雀创始人玉伯后来做 YouMind。在一篇公开访谈中,他谈到产品应该帮助用户从收藏资料走向创作,也谈到希望工具更理解用户保存的材料、帮助推动下一步行动。这与我的体会很接近。这里是对访谈方向的转述,不把“笔记没人回看”当成他的原话。访谈原文
对我来说,接下来值得建设的能力,是让 AI 在合适的任务中,主动找回合适的旧资料。
写一个方案时,找出上次已经确认的客户要求;处理一个故障时,提醒我以前验证过的处理方法;重复一个项目时,把上一轮失败的条件带出来。
这让知识积累有机会进入一个循环:
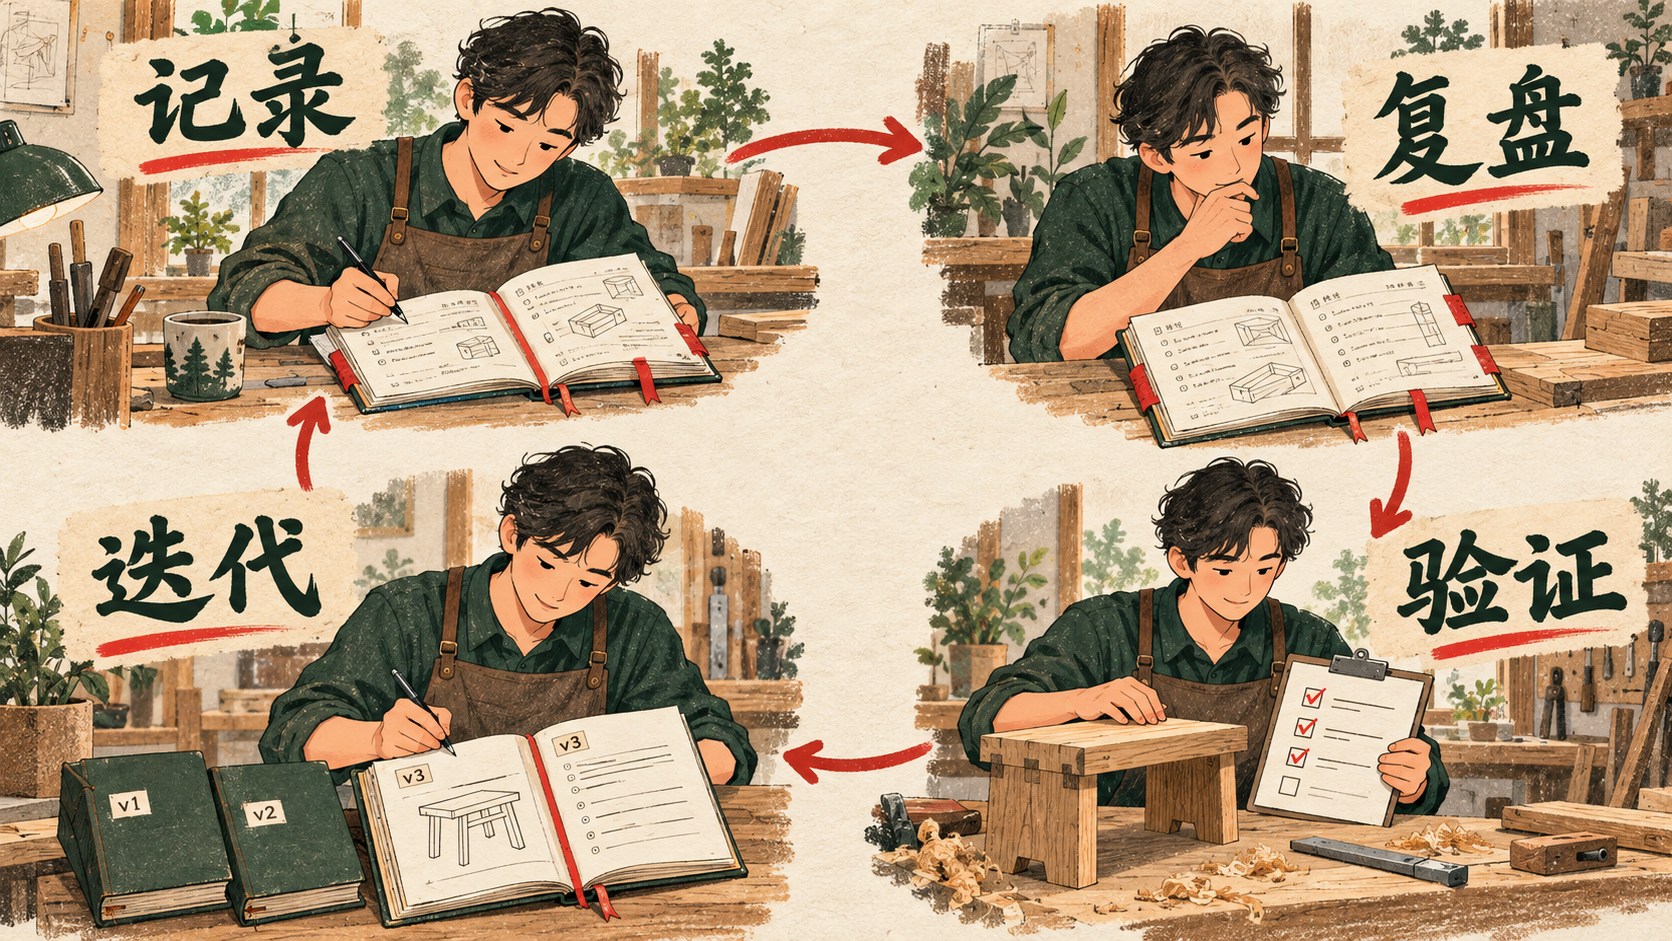
工作留下记录,记录提炼成事实和经验,经验在下一次任务中被调用,再用新的结果修正旧方法。
企业也一样。人员交接、项目复盘、客服处理、运营实验,都有大量可以继续利用的经验。要让它们成为组织资产,还需要明确谁能读取、谁来确认、哪些信息过期,以及哪里保存原始证据。
现在做这件事的也不只有 OpenViking。ChatGPT 有产品内记忆,AWS 有 AgentCore Memory,Google 的 Agent Platform 也提供 Memory Bank。它们的定位和开放方式不同,但都在处理跨会话积累与上下文延续的问题,不能简单当成同一种产品。OpenAI 记忆说明;AWS 文档;Google 文档
我希望 Skill 简单,而且能改得动
说到 Skill,我现在越来越倾向于结构简单、用途明确、能够验证和迭代。
一份方法说明,我更希望它讲清楚五件事:什么时候用,需要什么材料,主要步骤是什么,怎样判断成功,遇到什么情况应该停下来。
拿“竞品分析”举例,真正有用的方法应该提醒我:明确市场和产品范围,核实数据来源,区分销量事实和估算,最后输出可以支持决策的结论。它不需要为了显得专业,先安排一大堆角色互相开会。
不懂代码的人,也可以先把自己平时怎样做事讲出来,让 AI 帮忙整理成 Skill 初稿。复杂脚本和系统接入可能仍需要技术支持,但方法本身应该让使用者看得懂。
每次任务结束,再问几个具体问题:哪里重复劳动了?哪个步骤缺材料?哪句话导致误解?这次结果支持修改哪条规则?
AI 可以协助提炼经验、提出修订建议,并在授权后生成新版本。但“工具自动记录了经验”,不等于“Skill 已经自动改对”。OpenViking 的经验轨迹也只表明读取与后续轨迹存在关联,不能单凭次数证明它造成了成功。经验追踪说明
我更希望形成的,是一套每次做完都能复盘、改后有样例验证、出问题能回退的方法。
6. Token花得值,比花得少更重要
我的态度可能和一些人不同:我不会把少用 Token 本身当作目标。
如果多花一些 Token,能核对重要事实、减少返工、提高交付质量,最后赚回来,我认为这笔消耗有价值。
这里的“赚回来”,可以是收入,也可以是省下的工作时间、更少的错误,或者以后能够重复使用的一份成果。
但这并不意味着调用越多越好。反复检索无关内容、把整段历史塞给每个模型、没有结果地循环重试,花掉的钱很难变成积累。
我愿意为有效的核验、推理和复盘付费,也希望那些反复消耗却不产生价值的步骤,能被逐步改掉。
所以,我看待记忆系统的价值,也不会只看今天省了多少 Token。我更关心:做过的工作,有多少留了下来,又有多少在下一次真正派上了用场。
过去,换一个 AI,我经常要重新介绍一遍自己。现在我希望,工具可以继续换,工作的积累能够接着走。
创作说明:本文基于前程的实际使用经历整理,AI参与资料核验与文字编辑;插图由AI生成,均为讲解示意。产品能力以实际版本、权限与接入方式为准。